

工程團隊評估一個外部或內部提供的只讀 API,往往在規格需求確定後才真正進入技術選型。手邊常見的評估清單通常圍繞定價級距、文件清晰度、SDK 支援或社群討論度。這些指標不可或缺,但系統上線半年後真正引發維運災難的隱患,大多潛藏在讀取路徑本身的架構設計之中。
只讀操作因不涉及遠端資料變更,容易給人低風險的錯覺,進而讓團隊忽略了底層細節。直到儀表板正式上線、ETL 排程每日密集拉取、第三方應用每分鐘定時輪詢時,才陸續發現副本延遲數十秒、配額被組織其他服務擠占、或分頁只支援 offset 導致效能雪崩。這些實質差異很少被列在供應商首頁的亮點列表上。
評估只讀API適用場景與技術選型時,必須把底層鏈路逐一拆解。下文整理的一致性級別、限流機制與快取行為,均依循公開技術標準或主流雲端架構設計;涉及談判與維運經驗之處,則作為工程決策的衡量基準。
一、資料新鮮度:確認業務容許的陳舊界限
同樣是讀取操作,底層可能源自資料庫主庫、跨區域複本、物化檢視、快取層,甚至是批次同步的離線倉儲。鏈路越長,成本與架構負載通常越低,但資料陳舊時間也越長。評估時務必將文件中的「即時」或「近即時」量化為可驗收的具體秒數,並區分平均延遲與尾延遲(P99)。平均延遲兩秒、尾延遲達九十秒的端點,在批次分析中完全可行,但放在客服即時對話或狀態查詢中就會造成業務混亂。
內部營運報表對五分鐘前的彙總數字通常不敏感,將預算耗費在毫秒級一致性並不划算;相反地,客服系統必須查驗剛完成的交易,這類只讀API適用場景強烈依賴讀寫一致性(Read-your-writes)。部分系統透過專屬標頭或工作階段標籤提供保證,部分則要求強制讀取主庫端點,二者的調用成本與配額限制往往截然不同。
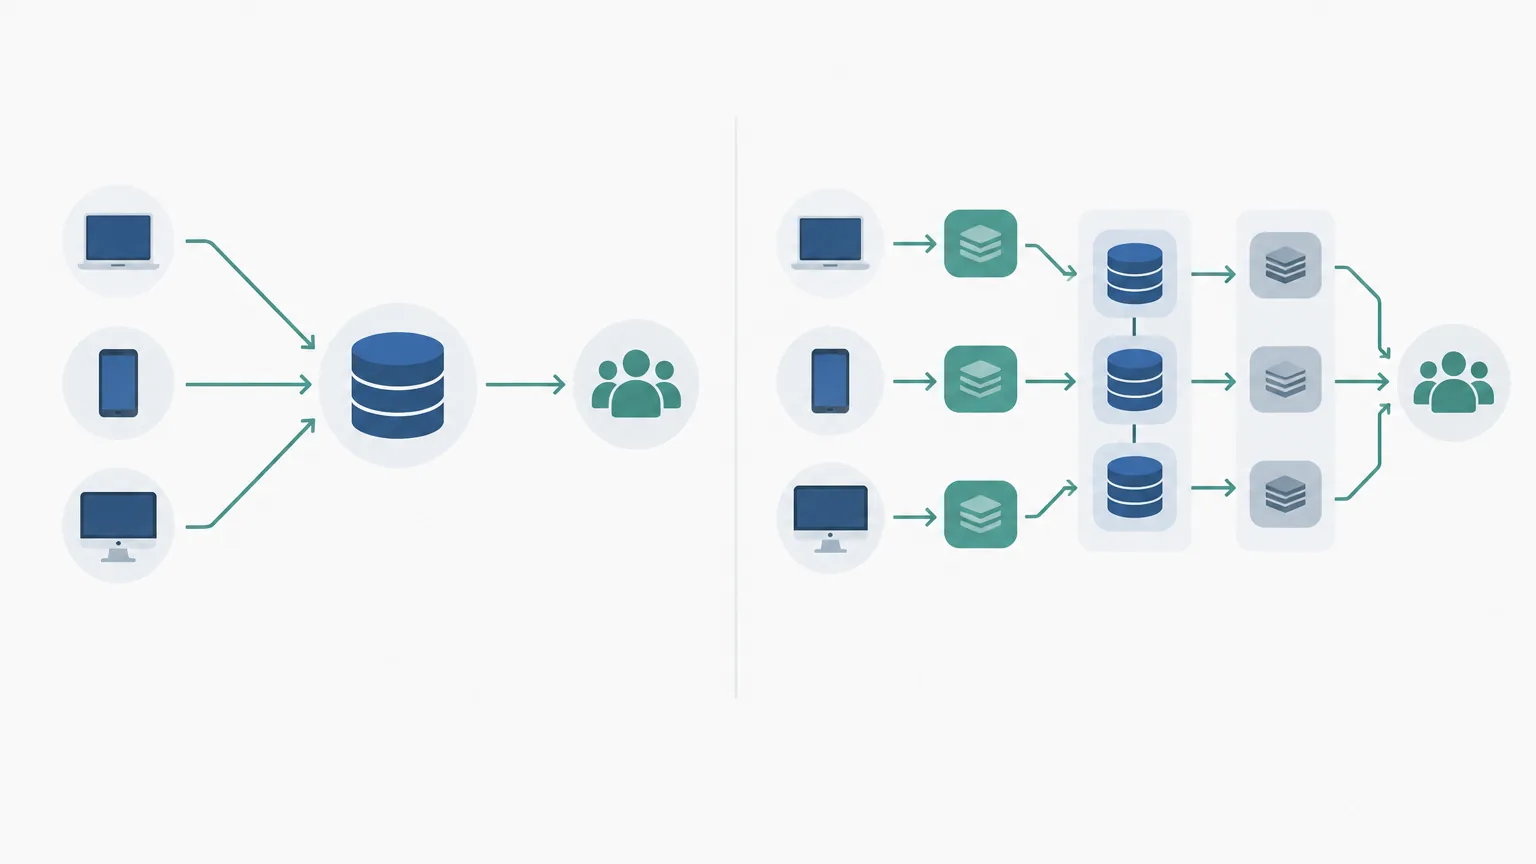
在技術驗證(PoC)階段應重點核查:跨區讀取是否能精確監控複本落後時間;是否具備單調讀取(Monotonic Read)保證以防止介面重整後資料倒退;以及非同步寫入完成與讀取介面資料一致的實際耗時。
二、一致性等級與合約承諾力度
資料一致性並非單純的強一致與最終一致二選一。以分散式資料庫的一致性模型為例(如 Microsoft Learn 的 Azure Cosmos DB 一致性層級文件所述),系統架構可能支援強一致(Strong)、限定過期(Bounded Staleness)、工作階段一致(Session)、一致前綴(Consistent Prefix)與最終一致(Eventual)。值得注意的是,特定一致性選項有其架構先決條件,例如限定過期在設定多個寫入區域的帳戶中不支援(Not supported)。這表明一致性模型在不同部署拓撲下存在硬性限制。
比較只讀介面時,關鍵在於此項保證究竟是寫入具備賠償責任的 SLA(服務水準協議),還是僅作為技術架構的最佳努力(Best Effort)。在庫存扣減查驗、授權校驗等關鍵環節,承諾強度高於帳面延遲;而在內容聚合、商品型錄等只讀API適用場景,過度追求強一致只會帶來昂貴的帳單與回應延遲。
架構決策原則:若介面資料延遲十秒僅造成畫面更新延緩,最終一致性即可勝任;若十秒延遲會引發重複授權或越權存取,該鏈路必須強制使用更高階的一致性保證。
三、配額架構與限流邊界行為
帳面上的「每分鐘 600 次」無法完整描繪實際限流特徵。限流機制涉及多種演算法(如令牌桶、滑動視窗、漏桶等第三方工程實踐),不同演算法在邊界流量下的放行特徵截然不同。
- 計數維度:限流是以呼叫端來源 IP、API Key、使用者權杖、組織席位還是特定端點為單位計算。若配額綁定在組織帳號而非單一金鑰,多條業務線共用時極易觸發連鎖封鎖。
- 視窗特性:固定視窗容易在視窗交界處湧入雙倍尖峰;滑動視窗與令牌桶則平滑許多,能更好地容納批次發起的讀取任務。
- 突發容量(Burst Capacity):服務端是否允許短暫突破基準閾值,直接決定了快取預熱、系統啟動與批次拉取場景下的穩定性。
- 超限回應標準:依照 RFC 9110 定義的 Retry-After 規範,健全的介面應在回傳 HTTP 429 或 503 時明確附帶等待秒數。部分系統超限時直接中斷連線或回傳空陣列,後者極易導致呼叫端誤判資料已被清空。
四、權限邊界與金鑰控管能力
只讀憑證在權限細緻度上的落差極大。粗粒度的權限模型僅提供全域讀取權限,一旦外洩便面臨全盤資料暴露;精細的憑證體系則可限制至特定資源路徑、資料集或敏感欄位。
面向前端直讀或外部合作夥伴的只讀API適用場景,憑證控管尤為關鍵:
- 是否支援核發短效權杖(Ephemeral Tokens),避免長效 Key 暴露於客戶端。
- 能否針對讀取金鑰配置來源 IP 白名單及嚴格的跨來源資源共用(CORS)限制。
- 是否支援無停機換鑰(雙金鑰平行並存),避免憑證輪替期間排程任務中斷。
五、分頁與異動資料捕獲能力
在大規模資料同步場景中,讀取介面的分頁與增量設計直接決定資料處理管道的複雜度與運算負載:
- 分頁機制:Offset 分頁在深分頁時效能較差,且資料持續寫入時極易發生漏讀或重複;Cursor(游標)分頁在大資料量遍歷下兼顧效能與穩定性。
- 異動識別(CDC):依靠時間戳進行增量讀取時,需確認時間精確度、無關欄位更新是否引發假性異動,以及硬刪除紀錄是否具備墓碑機制(Tombstone)。
- 即時串流支援:對於高頻資料管道,支援 Webhook 或變更串流(Change Streams)的介面能大幅減輕定時輪詢帶來的資源耗損。
| 同步機制 | 適用規模 | 主要工程代價與約束 |
|---|---|---|
| 全量拉取覆寫 | 數萬筆以內、變動頻繁 | 無法保留歷史刪除標記,網路頻寬與計算比對開銷較大 |
| 時間戳增量讀取 | 數十萬至數百萬筆 | 需依賴可靠的更新時間戳與刪除標記,防範同秒異動遺漏 |
| 變更串流/事件通知 | 大規模、要求秒級同步 | 客戶端需自建等冪重試、亂序校正與中斷續傳邏輯 |
六、欄位裁剪與查詢靈活度
回傳固定結構的端點雖然呼叫簡單,但在高吞吐量資料處理情境中,多餘欄位會無謂佔用頻寬與記憶體反序列化開銷。支援欄位篩選(如 fields 或 GraphQL 語法)的端點能大幅壓縮資料體積。但需注意,GraphQL 這類靈活查詢通常會轉化為查詢複雜度計費模型,與常見的請求次數模型存在明顯計算差異。
七、HTTP 快取與條件請求支援
依據 RFC 9111: HTTP Caching 規範,快取控制是服務端與客戶端共同遵循的協定標準。在只讀端點的整合中,完善的條件請求機制具備極高價值:
- ETag 與 If-None-Match:資料未異動時回傳 HTTP 304 Not Modified,能徹底免除重複資料的網路傳輸。需注意:在 304 請求不計費或僅按低費率計費的前提下,此機制可顯著降低頻寬成本;但仍需查驗特定供應商是否將 304 視為常規請求計費。
- Cache-Control 標頭:明確的 max-age 與 s-maxage 能讓邊緣 CDN 節點分擔流量,這在公開目錄與大型熱門查詢場景中效果顯著。
八、錯誤合約與冪等重試策略
只讀請求在語義上天然具備冪等性,但在自動重試機制的建立上,仍需依賴穩健的錯誤回應合約。結構化的錯誤格式(如明確的機器讀取錯誤代碼而非自由文字)能確保客戶端自動分支處理。批次查詢端點需特別留意「部分成功」的情境,避免程式碼將夾帶錯誤的 200 回應誤判為正常全量資料。
九、計費模型與成本結構
不同服務對唯讀流量的計費維度可能差異巨大,常見包含按調用次數、傳輸頻寬(Egress)、席位訂閱或運算複雜度計費。針對多數只讀API適用場景,需將尖峰流量倍數與全量同步頻率納入算式,避免上線後因高頻輪詢觸發階梯式高額帳單。
十、生命週期管理與棄用預警
整合長期跑批的讀取排程,最忌端點或欄位無預警異動。規範完善的供應商會遵循 RFC 8594 提供的 Sunset 標頭或明確的生命週期承諾,提早預告過期時間,並保證舊版介面至少維持數季以上的維護窗口。
十一、合規審計與存取落地
唯讀查詢同樣會留下合規痕跡。受金融、個資或醫療法規監管的領域,必須核驗服務端是否對讀取操作提供不可篡改的存取日誌(Audit Trail)、日誌保留期限,以及資料主體所在儲存區域,以符合跨境資料監管標準。
十二、不同應用用途的優先級權重
評估時不應尋求「全能」的 API,而應根據不同用途進行針對性取捨:
| 只讀API適用場景 | 首要關注指標 | 架構上可接受的折衷 |
|---|---|---|
| 內部 BI 與數據儀表板 | 條件請求(304)、配額結構、查詢過濾靈活性 | 容許分鐘級複製延遲、無變更即時串流 |
| 資料倉儲 ETL / ELT 批次 | 游標分頁、可靠更新戳記、墓碑刪除機制 | 單次請求延遲較高、欄位不可自由裁剪 |
| 前端用戶端直連讀取 | 短效 Token 機制、CORS 支援、邊緣快取標頭 | 查詢過濾表達力較弱、僅支援固定結構 |
| 合作夥伴安全資料交換 | 精細存取權限、讀取審計日誌、獨立租戶配額 | 網路延遲較長、無即時主動推播通知 |
| 系統狀態監控與健康度輪詢 | 條件請求、Retry-After 標頭、突發配額彈性 | 回傳結構固定、缺乏跨實體聚合能力 |
常問問題 (FAQ)
Q1:為什麼只讀 API 也需要嚴格考量並發與限流演算法?
多數只讀請求雖不涉及資料庫行鎖衝突,但大量的批次查詢、深分頁拉取與複雜聚合運算,極易在底層分析資料庫或快取層形成熱點負載。若供應商採用固定視窗限流,瞬時尖峰可能直接導致呼叫被拒;若缺乏突發(Burst)容量,自動化排程也將頻繁觸發 429 錯誤。
Q2:在資料同步場景中,為什麼應優先挑選 Cursor(游標)分頁而非 Offset 分頁?
Offset 分頁在高併發寫入時容易遭遇「飄移現象」——若前置資料有新增或刪除,分頁讀取時會發生重複或漏讀記錄;此外,Offset 值過大時資料庫需掃描並丟棄大量歷史行,造成顯著的效能遞減。Cursor 分頁基於唯一的排序鍵錨點向前遍歷,既穩定又具備常數級別的讀取開銷。
Q3:HTTP 304 條件請求是否一定能為團隊節省呼叫費用?
這取決於提供方的具體計費政策。RFC 9111 定義了 304 在傳輸層面可免除主體資料,能確切節省網路頻寬與客戶端解析開銷;但部分 API 網關仍會將 HTTP 304 視為一次標準 API 調用計入月度帳單。在以降低維運成本為前提時,必須先行查驗計費規則。
Q4:對於高頻變更的資料,如何判斷該用 Webhook 還是定時輪詢只讀端點?
若業務要求秒級即時反應(如交易通知、狀態跳轉),且事件觸發頻率相對稀疏,Webhook 能節省大量無效請求;但若事件產生速率極高,處理 Webhook 的重試、去重與亂序會顯著提升架構複雜度。此時採用定時批次增量輪詢(搭配時間戳與 Cursor)通常具備更高的工程掌控力與穩定度。



评论 (0)